· control de Ryu
Agente Rainbow DQN
street_fighterParticipantes · LEIAFelipe Pacheco Zamorano · Diego Perea León · Santiago Saldaña Subías
Modelo de aprendizaje por refuerzo con y entrenamiento distribuido en Street Fighter II′: Special Champion Edition.
Una aprende a controlar a Ryu contra los doce rivales de la , en ocho dificultades de Sega Genesis. El proyecto explora cómo representar un combate, aprender secuencias de ataque y sostener una estrategia ante rivales cada vez más difíciles.
- Fecha del proyecto
- Modelo utilizado
- · ·
01Qué observa la política
El extractor lee variables de la y las : vida de ambos combatientes, posición relativa, distancia a la pared, proyectiles, velocidades, orientación y códigos de movimiento. La pantalla permite seguir el combate; las entradas de la red son esas variables numéricas.
Se extraen 23 valores por estado. Los identificadores de ambos personajes se convierten en vectores de 16 categorías: cada estado pasa a 53 valores y se apilan cuatro, para un total de 212. Esa historia reciente ayuda a distinguir un desplazamiento, un salto y un proyectil que avanza. La dificultad seleccionada no se añade como una entrada de la política.
- RAMEstado interno del combate
- 23 valoresVariables normalizadas
- 53 / estadoIdentidades one-hot
- 212 valores4 estados recientes
02Qué puede hacer
La red elige entre 72 acciones. Las primeras 63 combinan nueve direcciones —incluida la neutral— con siete opciones de ataque: ningún botón, tres intensidades de puñetazo y tres de patada. Una se mantiene durante cuatro .
Las otras nueve son : Hadouken ligero/fuerte, Shoryuken ligero/fuerte, Tatsumaki ligero/medio, saltos hacia delante/atrás y una secuencia de bloqueo. Las secuencias se definieron a mano; la política aprende cuándo seleccionarlas. Ejecutan dos o tres primitivas y se reflejan cuando el rival cambia de lado.
03Cómo calcula una acción
La red contiene 1,077,131 . Una transforma la entrada mediante dos capas de 256 unidades con . Después, la arquitectura separa el valor del estado y la ventaja de cada acción.
En lugar de asignar solo un número a cada acción, las ramas producen 51 del . La combinación da 72 . Su promedio es el ; durante la evaluación el agente elige el mayor.

04Qué aprende y por qué se llama Rainbow
El proyecto combina mejoras de con . Usa regresión de cuantiles en la parte distribucional, y exploración en lugar de . Esa elección evita fijar de antemano un para la escala de retornos de este juego.
- La red online elige la acción siguiente; una red objetivo estima su valor para construir el objetivo de aprendizaje.
- Comparte la representación del combate y separa lo favorable del estado de la ventaja de cada decisión.
- Reutiliza experiencias y muestrea con más frecuencia las que presentan errores de predicción grandes, compensando el sesgo del muestreo.
- Combina varias recompensas antes de estimar lo que falta por recibir. Aquí se combinan tres pasos con un .
- Ajusta la distribución del retorno de cada acción. Los 51 puntos son estimaciones aprendidas, no una distribución de botones aleatorios.
- Se actualiza con menos frecuencia que la online, para que los objetivos no cambien a la misma velocidad que la política.
El entrenamiento modifica los . El extractor de RAM, la codificación de personajes, las primitivas y las secuencias de macros permanecen definidos por el entorno. Una vez entrenado, el agente usa esos pesos para decidir durante el combate.
La señal de recompensa
La recompensa combina daño causado/recibido, resultado del round, coste de tiempo y de posición. Ganar aporta una recompensa positiva; perder o empatar añade una penalización. El agente también recibe señales durante el round. El componente posicional utiliza el cambio descontado de un potencial de distancia.
05Cómo se distribuyó el entrenamiento
separa recolectar experiencia de entrenar. Cada corre emuladores, explora con su propia ε y envía . Un central mantiene el replay, muestrea y actualiza la red en . Después publica nuevos pesos para los actores.
- ActoresEmuladores · distintas ε
- Replay centralTransiciones priorizadas
- LearnerLotes y en GPU
- PesosNuevas instantáneas a los actores
El amplió la distribución de dificultades: primero niveles bajos y después los ocho niveles, con más experiencia en los altos y una mezcla que conservó los bajos. El agente sigue encontrando rivales sencillos mientras aprende a enfrentar los más exigentes.
El replay permite aprender de experiencias anteriores: cada actualización toma un lote de transiciones, compara las predicciones con las recompensas observadas y ajusta los pesos de la red.
06Un año de evolución
- Septiembre–octubre 2025
Los primeros agentes aprendían mirando la pantalla
El equipo inició los experimentos con gym-retro y . Las imágenes se convertían a escala de grises, se reducían a 84 × 84 píxeles y se apilaban cuatro frames. Una aprendía a elegir combinaciones de botones; se exploraban recompensas por daño y victoria, y ajustes de .
- Marzo–abril 2026
De píxeles a variables del combate
El equipo construyó un entorno sobre BizHawk que conecta el juego con el entrenamiento en Python. El agente pasó a observar vida, posiciones, velocidades y proyectiles mediante la memoria del juego. Esta representación hizo explícita la información necesaria para aprender; el entrenamiento por curriculum introdujo rivales y dificultades de forma gradual.
- Mayo–junio 2026
Más formas de entrenar y comparar
Se ampliaron los espacios de acciones, el curriculum automático y las herramientas para observar decisiones. También se incorporaron pruebas entre agentes y una estructura de liga para explorar entrenamiento con oponentes aprendidos. PPO fue la base del desarrollo de esta etapa.
- Agosto 2026
Comparar estrategias evolutivas y aprendizaje distribucional
Se estudiaron políticas y una variante de Rainbow DQN con regresión de cuantiles. La evaluación comenzó a variar los arranques y a introducir ruido en las acciones, para distinguir una estrategia que repite una secuencia de otra que responde a cambios del combate. Se revisó también la señal de recompensa para que ganar y perder produjeran incentivos correctos.
- Agosto 2026
Entrenamiento distribuido y peleas completas
permitió reunir experiencia de varios emuladores. Se añadieron macroacciones y se amplió el entrenamiento a los ocho niveles de CPU. La evaluación pasó de un round de apertura a peleas al mejor de tres, donde el agente necesita mantener su desempeño después de los cambios entre rounds.
Las etapas exploran representaciones y métodos distintos. Los primeros agentes basados en imágenes y las pruebas de liga forman parte de la historia; los benchmarks siguientes corresponden a las políticas evaluadas sobre variables de memoria frente a la CPU.
07Resultados
La dificultad de la , la duración de la prueba y la variación del arranque cambian lo que se está midiendo. Por eso ganar el primer y ganar una producen porcentajes diferentes.
| Prueba | Victorias | Resultado | Qué mide |
|---|---|---|---|
| Peleas completas · nivel 8 | 323 / 360 | 89.7% | Ganar dos rounds antes que el rival. 30 peleas por cada CPU. |
| Primer round · nivel 8 | 90 / 96 | 93.8% | Ganar solo el round de apertura en la dificultad máxima. |
| Primer round · niveles 1–8 | 758 / 768 | 98.7% | Promedio con la misma cantidad de en cada dificultad. |
| Primer round · niveles 1–4 | 96 / 96 por nivel | 100% observado | Ninguna derrota en esos bancos; no significa ganar cualquier partida posible. |
Estas pruebas utilizan los doce rivales, de hasta 30 pasos y ningún ruido añadido a las acciones. El promedio sobre ocho niveles incluye CPU más sencillas: no equivale al resultado de la dificultad máxima.
Comparación entre modelos · nivel 1
Se compararon dos políticas , tres variantes evolutivas y dos etapas de Ape-X sobre los mismos doce estados iniciales. Se aplicaron tres condiciones: , desfase aleatorio del arranque y .

| Modelo | |||
|---|---|---|---|
| 90.6%87 / 96 | 93.1%67 / 72 | 95.8%69 / 72 | |
| 74.0%71 / 96 | 80.6%58 / 72 | 81.9%59 / 72 | |
| 83.3% †20 / 24 | 63.9%46 / 72 | 76.4%55 / 72 | |
| 75.0% †18 / 24 | 75.0%54 / 72 | 65.3%47 / 72 | |
| 83.3% †20 / 24 | 79.2%57 / 72 | 56.9%41 / 72 | |
| 100.0% †24 / 24 | 91.7%66 / 72 | 95.8%69 / 72 | |
| 100.0% †24 / 24 | 100.0%96 / 96 | 100.0%96 / 96 |
Cómo leer el 100%
† Con las de DQN y OpenES y un arranque fijo, las repeticiones pueden producir exactamente la misma pelea. Ese 100% describe las secuencias del banco; repetirlas no añade partidas independientes. El desfase y el ruido cambian las condiciones para comprobar cuánto depende el agente de esa secuencia.
Un 100% con desfase significa que no hubo derrotas en la muestra observada. Sigue siendo un conjunto limitado de estados y perturbaciones, con arranques que pueden repetirse. Los intervalos tampoco recogen todas las fuentes de incertidumbre. En esta comparación PPO elige acciones de forma ; DQN y OpenES eligen su acción de mayor puntuación. Los presupuestos de entrenamiento son diferentes.
Dificultad · modelo 3291
| Nivel de | Victorias | Porcentaje |
|---|---|---|
| 1 | 96 / 96 | 100.0% |
| 2 | 96 / 96 | 100.0% |
| 3 | 96 / 96 | 100.0% |
| 4 | 96 / 96 | 100.0% |
| 5 | 95 / 96 | 99.0% |
| 6 | 95 / 96 | 99.0% |
| 7 | 94 / 96 | 97.9% |
| 8 | 90 / 96 | 93.8% |
Evolución de Rainbow DQN por dificultad
Tres del mismo agente, evaluados con desfase en los mismos bancos. Los paneles comparan los modelos 511, 1212 y 3291 en niveles 1–6, y los modelos 1212 y 3291 en niveles 7–8.
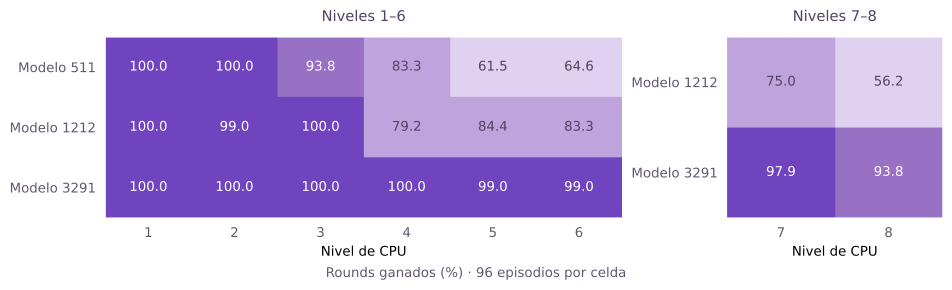
3291 identifica una instantánea de pesos del entrenamiento; no es un número de generación. Cada celda resume 96 episodios de primer round.
Peleas completas · dificultad máxima
Ganar una pelea requiere dos victorias de round. El resultado de 323/360 es 89.7%, con un de 86.2–92.5%. La mayor parte de las derrotas se concentra en Balrog, Guile y E. Honda: 35 de las 37 pérdidas.

Conteos e intervalos por rival
| Rival | Victorias | Porcentaje | |
|---|---|---|---|
| Balrog | 16 / 30 | 53.3% | 36.1–69.8% |
| Blanka | 30 / 30 | 100.0% | 88.6–100.0% |
| Chun-Li | 30 / 30 | 100.0% | 88.6–100.0% |
| Dhalsim | 30 / 30 | 100.0% | 88.6–100.0% |
| E. Honda | 20 / 30 | 66.7% | 48.8–80.8% |
| Guile | 19 / 30 | 63.3% | 45.5–78.1% |
| Ken | 30 / 30 | 100.0% | 88.6–100.0% |
| M. Bison | 28 / 30 | 93.3% | 78.7–98.2% |
| Ryu | 30 / 30 | 100.0% | 88.6–100.0% |
| Sagat | 30 / 30 | 100.0% | 88.6–100.0% |
| Vega | 30 / 30 | 100.0% | 88.6–100.0% |
| Zangief | 30 / 30 | 100.0% | 88.6–100.0% |
Alcance
Los resultados corresponden a Ryu frente a la CPU de Street Fighter II′: Special Champion Edition, usando variables de memoria y macros definidas previamente. No establecen desempeño contra humanos ni con otros personajes, ediciones o estados iniciales fuera del banco evaluado.